 Alpha Digitalagentur
6. Unterrichtsblock
6. Unterrichtsblock Wiederholung: Python-Grundlagen Folgende Konzepte kennst du schon aus dem Python Unterricht. Hier kommt eine kurze Wiederholung, da sie wichtig sind für die weitere Unterrichtsreihe. Machine Learning Algorithmus Mit Hilfe von Machine Learning lernen wir die passenden Gewichte mithilfe der Perzeptron-Lernregel. Diese Regel dient dazu, die Gewichte W so anzupassen, dass eine Trennlinie (bzw. […]

Kursinhalte
- Python Grundlagen
- Perzeptron Lernregel
Wiederholung: Python-Grundlagen
Folgende Konzepte kennst du schon aus dem Python Unterricht. Hier kommt eine kurze Wiederholung, da sie wichtig sind für die weitere Unterrichtsreihe.
- Funktionen: Funktionen helfen uns, Code zu strukturieren und wiederzuverwenden. Sie werden nur dann ausgeführt, wenn sie aufgerufen werden.
- Mehr zu Funktionen findest du im Python-Entwicklerkurs: https://pythonentwicklerkurs.de/1-2-semester/9-unterrichtsblock/
- Booleans: Wahrheitswerte steuern Entscheidungen im Code.
- Mehr zu Booleans findest du im Python-Entwicklerkurs: https://pythonentwicklerkurs.de/1-2-semester/4-unterrichtsblock/
- if-Statements: Entscheidungen treffen – je nach Bedingung.
- Mehr zu if-Statements findest du im Python-Entwicklerkurs: https://pythonentwicklerkurs.de/1-2-semester/8-unterrichtsblock/
- for-Schleifen: Wiederholungen über Listen oder Bereiche.
- Mehr zu for-Schleifen findest du im Python-Entwicklerkurs: https://pythonentwicklerkurs.de/1-2-semester/8-unterrichtsblock/
- while-Schleifen: Wiederholen, solange eine Bedingung erfüllt ist.
- Mehr zu while-Schleifen findest du im Python-Entwicklerkurs: https://pythonentwicklerkurs.de/1-2-semester/8-unterrichtsblock/
- Klassen definieren: Objekte und Strukturen bauen – wichtig für das Perzeptron.
- Mehr zu Klassen findest du im Python-Entwicklerkurs: https://pythonentwicklerkurs.de/1-2-semester/11-unterrichtsblock/
Machine Learning Algorithmus
Mit Hilfe von Machine Learning lernen wir die passenden Gewichte mithilfe der Perzeptron-Lernregel. Diese Regel dient dazu, die Gewichte W so anzupassen, dass eine Trennlinie (bzw. Trennebene) in die Trainingsdaten gelegt wird – sodass eine Klasse oberhalb und die andere unterhalb dieser Grenze liegt.
Gewichte sind Zahlen, die bestimmen, wie stark einzelne Eingabewerte das Ergebnis beeinflussen. Sie werden mit den Eingaben multipliziert und entscheiden, ob das Perzeptron „aktiviert“ wird – also ob es z. B. einen Hund erkennt oder nicht. Durch das Lernen verändern sich die Gewichte so, dass die Entscheidung immer besser wird.
Trennlinie einzeichnen
Funktion zur Visualisierung eines Perzeptron-Modells
Wenn wir die Funktion ausführen bekommen wir diesen Plot:
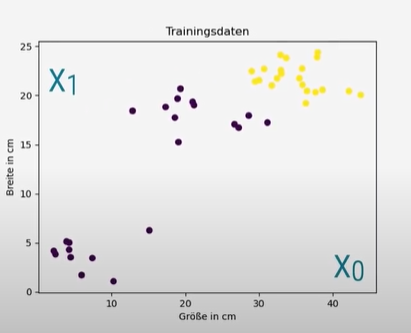
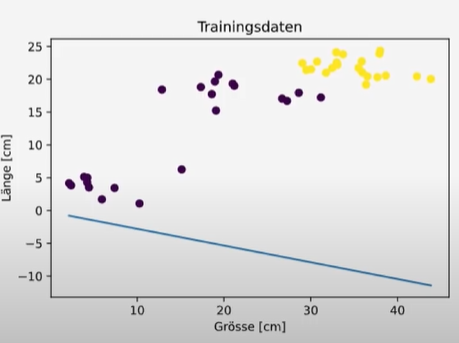
Jetzt fehlt noch die Trennlinie. Die Linie ist definiert durch w*x > 0. Wobei w*x das Skalarprodukt der Vektoren w und x ist. Nun muss die Ungleichung umgeschrieben werden:
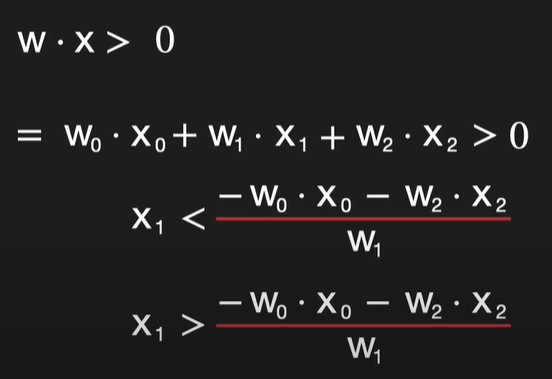
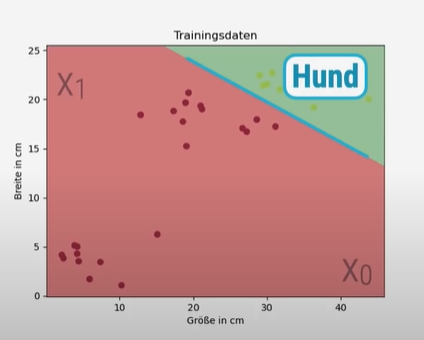
Wenn jetzt W₁ positiv ist und das Symbol ein größer ist, ist die Klasse Hund über der Linie.
Wenn jetzt W₁ negativ ist und das Symbol beim Umschreiben zu kleiner wird, ist die Klasse Hund unter der Linie.
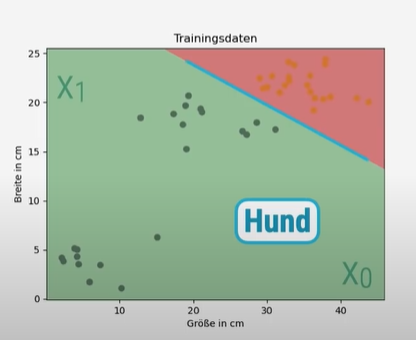
Nun fügen wir die Trennlinie ein und erhalten folgenden Plot:
Perzeptron-Lernregel
Damit die Trennlinie an der richtigen Stelle liegt, brauchen wir passende Gewichte – diese lernen wir mithilfe der Perzeptron-Lernregel.
Was ist die Perzeptron-Lernregel?
Die Perzeptron-Lernregel ist ein Algorithmus der zum Supervised Learning gehört.
Label und Aufgaben vergleichen
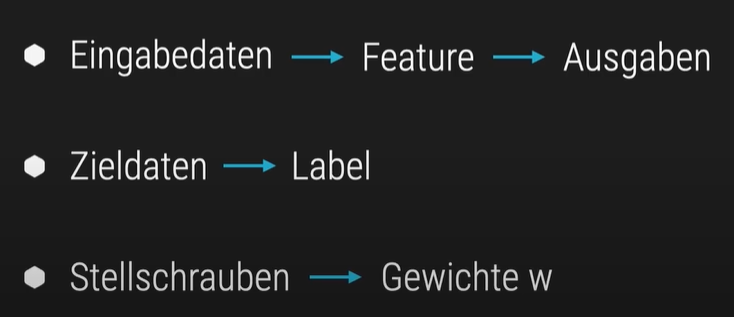
Hinweis: Die Kombinationen aus ausgabe und label ergeben vier mögliche binäre Paare:
- 00 und 11 bedeuten, dass das Perzeptron korrekt klassifiziert hat (Ausgabe stimmt mit dem Label überein).
- 01 steht für einen falsch-negativen Fall: Das Modell sagt „Nein“, obwohl die richtige Antwort „Ja“ gewesen wäre.
- 10 steht für einen falsch-positiven Fall: Das Modell sagt „Ja“, obwohl die richtige Antwort „Nein“ gewesen wäre.
Gewichte anpassen
Im Vergleich zum vorherigen Code, der nur die Fälle prüft und mit pass darauf reagiert, kommt hier Lernlogik hinzu: Das Perzeptron passt seine Gewichtungen an, wenn es falsch liegt.
- Fall 2 (ausgabe = 0, label = 1): Das Modell hat „Nein“ gesagt, obwohl die richtige Antwort „Ja“ gewesen wäre → Fehler. → Lösung: Die Eingabe x wird zu den Gewichten w hinzuaddiert, um die Entscheidung in Zukunft zu korrigieren.
- Fall 3 (ausgabe = 1, label = 0): Das Modell hat „Ja“ gesagt, obwohl die richtige Antwort „Nein“ gewesen wäre → Fehler. → Lösung: Die Eingabe x wird von den Gewichten w abgezogen, um die Entscheidung in Zukunft zu korrigieren.
Diese Gewichtsanpassung ist das zentrale Lernprinzip des Perzeptrons: Es verändert sich durch Fehler – und wird dadurch besser in der Klassifikation.
oder kürzer:
Dieser Code ist eine kompakte Version des Lernalgorithmus für ein Perzeptron. Er kombiniert die Fehlerberechnung und die Gewichtsanpassung in nur zwei Zeilen:
- Fehler berechnen:delta = label - perzeptron(w, x) → Vergleicht die tatsächliche Zielausgabe (label) mit der vom Perzeptron berechneten Ausgabe. → Ergebnis:
- delta = 0 → korrekt klassifiziert
- delta = +1 → falsch negativ (Modell hat 0 gesagt, obwohl 1 richtig wäre)
- delta = -1 → falsch positiv (Modell hat 1 gesagt, obwohl 0 richtig wäre)
- Gewichte anpassen: w += delta * x → Wenn delta = 0, passiert nichts. → Wenn delta = +1, wird x zu w addiert → Verstärkung → Wenn delta = -1, wird x von w subtrahiert → Abschwächung
Wie wurde der Code gekürzt?
Im vorherigen Beispiel war die Lernlogik in drei Bedingungen aufgeteilt:
python
Die kompakte Version ersetzt diese drei Fälle durch eine mathematische Formel:
- Sie nutzt die Tatsache, dass label - ausgabe direkt den Lernimpuls ergibt:
- 0 → kein Fehler
- +1 → Verstärken
- –1 → Abschwächen
Dadurch wird der Code kürzer, eleganter und leichter skalierbar, z. B. für Vektoren oder Batch-Verarbeitung.
Der bisherige Code zeigt, wie das Perzeptron eine einzelne Eingabe klassifiziert – also ob z. B. ein Tier als „Hund“ erkannt wird oder nicht. Das ist ein wichtiger Schritt, aber: Ein einzelnes Beispiel reicht nicht aus, damit das Modell wirklich lernt.
Damit das Perzeptron die richtige Trennlinie findet, muss es alle Trainingsdaten durchlaufen – also jedes Tier einzeln prüfen. Und bei jedem Fehler muss es die Gewichte anpassen, damit die Entscheidung beim nächsten Mal besser wird.
Das bedeutet:
- Wir brauchen eine Schleife, die alle Datenpunkte durchgeht
- Bei jedem Durchlauf wird geprüft, ob die Klassifikation stimmt
- Wenn nicht, werden die Gewichte verändert – das ist die eigentliche Lernregel
Erst wenn wir diesen Lernprozess eingebaut haben, kann das Perzeptron wirklich lernen, zwischen „Hund“ und „kein Hund“ zu unterscheiden. Der aktuelle Code ist also nur der Anfang – das Lernen fehlt noch.
Einbauen der For-Schleife
Als erstes müssen wir uns überlegen über welche Daten wir iterieren. Die benötigten Variablen sind w, x und Label.
Wir wollen die Lernregel über alle Label und alle Feature durchrechnen, also müssen wir über 2 Listen iterieren.
Dieser Code zeigt den vollständigen Lernschritt: Das Modell geht alle Trainingsbeispiele durch, prüft die Klassifikation und passt die Gewichtung an, wenn es falsch liegt. So „lernt“ das Perzeptron, die Trennlinie zwischen Klassen zu verbessern.
oder:
Hinweis:
Die kompakte Schreibweise mit zip() macht den Code kürzer und besser lesbar, da Eingaben und Labels direkt als Paare verarbeitet werden – ganz ohne Indexverwaltung. Der Lernschritt wird klar strukturiert: Fehler werden berechnet, Gewichte angepasst und Fehlklassifikationen gezählt. So entsteht ein eleganter, praxisnaher Code, der sich ideal für den Einstieg ins maschinelle Lernen mit dem Perzeptron eignet.
Nachdem der Code mit einer For-Schleife ausgeführt wurde, zeigt die Visualisierung, dass die Trennlinie immer noch weit von der optimalen Lösung entfernt ist. Eine genauere Analyse offenbart:
- Nur ein Datenpunkt falsch klassifiziert: Zuerst wurden alle „Hunde“-Daten korrekt klassifiziert. Beim ersten „Nicht-Hund“-Datenpunkt wurde ein Fehler gemacht, woraufhin die Gewichte angepasst wurden.
- Seitenwechsel: Die Anpassung der Gewichte führte dazu, dass die Klassen die Seiten der Trennlinie wechselten, sodass nun alle Datenpunkte als „Nicht-Hund“ klassifiziert wurden.
- Das Problem: Eine einmalige Iteration über den Datensatz (eine Epoche genannt) reicht nicht aus, um die optimale Trennlinie zu finden.
Die Lösung: Man muss die For-Schleife (also eine Epoche) mehrmals wiederholen (z.B. 10, 20 oder 100 Mal), bis die Perzeptron-Lernregel die richtige Linie findet. Dies wird Thema des nächsten Videos sein, das die Verwendung von While-Schleifen zur Steuerung der Epochenanzahl einführen wird.
Einbauen der While-Schleifen
Die zuvor entwickelte For-Schleife, die eine einzelne Trainings-Epoche abbildet, wird nun in eine While-Schleife eingebettet. Dadurch lässt sich das Perzeptron über mehrere Epochen hinweg trainieren – solange Fehler auftreten und eine maximale Epochenzahl (z. B. 100) nicht überschritten wird.
Lernbedingung
Die While-Schleife läuft unter zwei Bedingungen:
- Es sind noch Klassifizierungsfehler vorhanden (fehler != 0)
- Die maximale Anzahl an Epochen wurde noch nicht erreicht
Fehlerüberwachung
Vor jeder Epoche wird die Fehleranzahl auf null gesetzt. Innerhalb der For-Schleife wird sie bei jeder falschen Klassifizierung erhöht. So lässt sich die Lernfortschritt gezielt überwachen.
Vorzeitiges Beenden
Sobald keine Fehler mehr auftreten, wird die Schleife mit break beendet. Das spart Rechenzeit und zeigt, dass das Modell eine fehlerfreie Trennung gefunden hat.
Anmerkung zur ELSE-Klausel:
Die else nach der while-Schleife wird ausgeführt, wenn die Schleife normal durchläuft, d.h., wenn sie nicht durch break verlassen wird. Im Kontext dieses Codes bedeutet das, dass das break nicht ausgelöst wurde (weil fehler[iter] == 0 nie erreicht wurde) und iter bis max_epochs hochgezählt wurde – also wurde keine Lösung gefunden. Das ist die korrekte logische Verwendung der else-Klausel bei while-Schleifen in Python.
Problem: Langsame Konvergenz
Auch nach 100 Epochen kann es vorkommen, dass das Perzeptron keine Lösung findet. In einem Beispiel dauert es über 9.000 Epochen, bis die Fehlerrate auf null sinkt – ein Hinweis auf ineffizientes Lernen.
Lösung: Normalisierung der Trainingsdaten
Die Eingabedaten werden so skaliert, dass sie in einen definierten Wertebereich fallen – z. B. zwischen 0 und 1. Dadurch wird das Lernverhalten stabiler und schneller.
Die Maximalwerte der einzelnen Features werden ermittelt, und alle Werte durch diese Maxima geteilt. So entsteht ein gleichmäßiger Wertebereich für alle Eingaben.
Nach der Normalisierung sinkt die Anzahl der benötigten Epochen drastisch – von über 9.000 auf nur drei. Ein eindrucksvolles Beispiel für die Bedeutung von „Best Practices“ im Machine Learning.
Jetzt sollte die Trennlinie richtig angezeigt werden.
Nun sollte der bisherige Code so aussehen:
Video:
#14: https://www.youtube.com/watch?v=DXpk5hniOK4&list=PLIYzsTnFhywyjBon1_tE4ZGVzXAx5FpWr&index=14
#15: https://www.youtube.com/watch?v=-U9mQl4R2WA&list=PLIYzsTnFhywyjBon1_tE4ZGVzXAx5FpWr&index=15
#16: https://www.youtube.com/watch?v=Gg4-KNG76KI&list=PLIYzsTnFhywyjBon1_tE4ZGVzXAx5FpWr&index=17
#17: https://www.youtube.com/watch?v=GFUz1bENOUM&list=PLIYzsTnFhywyjBon1_tE4ZGVzXAx5FpWr&index=17 #18: https://www.youtube.com/watch?v=5xSbiRHUnZc&list=PLIYzsTnFhywyjBon1_tE4ZGVzXAx5FpWr&index=18
#19: https://www.youtube.com/watch?v=F84-PKteV4A&list=PLIYzsTnFhywyjBon1_tE4ZGVzXAx5FpWr&index=19