 Alpha Digitalagentur
7. Unterrichtsblock
7. Unterrichtsblock Klassen und Objekte in Python Klassen und Objekte sind dir aus dem Python-Unterricht bereits vertraut. In dieser Einheit lernst du, wie sich diese Konzepte nutzen lassen, um den Perzeptron-Code übersichtlich und modular zu gestalten. Durch die objektorientierte Umsetzung entsteht ein eigenständiges, flexibel einsetzbares Modell, das sich gut in komplexe Programme integrieren lässt und […]

Kursinhalte
- Klassen und Objekte in Python
- Strukturierung des Perzeptron-Modells
- Perzeptron als Objekt
- Perzeptron anwenden
- Perzeptron mit SKLearn
Klassen und Objekte in Python
Klassen und Objekte sind dir aus dem Python-Unterricht bereits vertraut. In dieser Einheit lernst du, wie sich diese Konzepte nutzen lassen, um den Perzeptron-Code übersichtlich und modular zu gestalten. Durch die objektorientierte Umsetzung entsteht ein eigenständiges, flexibel einsetzbares Modell, das sich gut in komplexe Programme integrieren lässt und die Wiederverwendbarkeit deutlich erhöht.
Was sind Objekte?
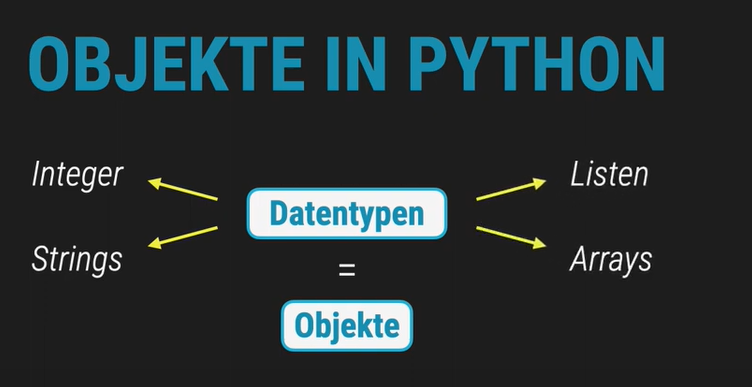
Python ist eine objektorientierte Sprache – nahezu alles, was darin verwendet wird (z. B. Zahlen, Zeichenketten, Listen), sind Objekte. Ein Objekt ist eine Kombination aus Daten (Variablen) und Funktionen (Methoden), die auf diese Daten angewendet werden können.
Mehr dazu findest du im Python-Kurs: https://pythonentwicklerkurs.de/1-2-semester/11-unterrichtsblock/
Klassen als Baupläne
Eine Klasse ist ein Bauplan für ein Objekt. Sie definiert, welche Eigenschaften (Variablen) und Fähigkeiten (Methoden) ein Objekt besitzt. In Python wird eine Klasse mit dem Schlüsselwort class definiert, der Name beginnt üblicherweise mit einem Großbuchstaben.
Die __init__-Funktion (Konstruktor)
Beim Erstellen eines neuen Objekts wird automatisch die __init__-Funktion aufgerufen. Sie dient der Initialisierung der Objektvariablen. Alle Methoden innerhalb einer Klasse erhalten self als ersten Parameter – eine Referenz auf das jeweilige Objekt. Das entspricht dem Konzept this in anderen Programmiersprachen.
Instanz- vs. Klassenvariablen
- Instanzvariablen werden mit self. definiert (z. B. self.gewichte) und sind spezifisch für jedes Objekt.
- Klassenvariablen werden ohne self. direkt in der Klasse definiert und gelten für alle Objekte gleichermaßen – sofern sie nicht überschrieben werden.
- Im folgenden werden wir nur Instanzvariablen verwenden:
Hinweis: Diese Struktur legt die Basis für ein objektorientiertes Perzeptron-Modell. Alle relevanten Parameter und Zustände sind als Instanzvariablen definiert, sodass jede Instanz unabhängig trainiert und ausgewertet werden kann. Die Fehlerliste erlaubt später eine Visualisierung des Lernfortschritts über die Epochen hinweg.
Strukturierung des Perzeptron-Modells
Der gesamte Perzeptron-Code wird in eine Klasse integriert. Die __init__-Funktion initialisiert Variablen wie self.gewichte, self.skalierungsfaktor, self.trainiert und self.fehler_historie. Methoden wie perceptron_funktion(), lernschritt(), visualisieren() und plotte_fehler() werden als Funktionen innerhalb der Klasse definiert. Alle internen Verweise auf Variablen und Methoden erfolgen über self. – z. B. self.gewichte. Ein Vorteil: Methoden müssen keine Gewichte mehr als Parameter erhalten, da sie direkt auf die Instanzvariablen zugreifen können.
Perzeptron-Code:
Perzeptron als Objekt
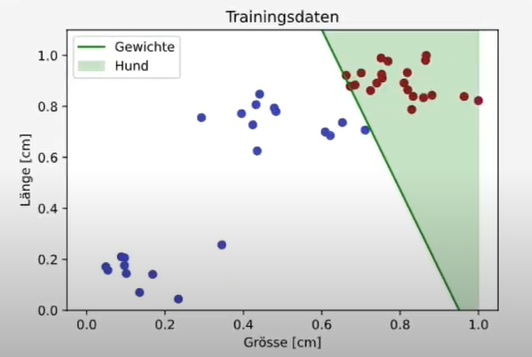
Ein Objekt der Klasse wird erstellt, z. B. perceptron = Perzeptron(100) – mit 100 als maximaler Epochenzahl. Der Lernschritt wird über perceptron.lernschritt(features, labels) ausgeführt. Neue Daten können anschließend mit perceptron.perceptron_funktion(x_neu) klassifiziert werden. Das Modell übernimmt dabei automatisch die Normalisierung, sofern es zuvor trainiert wurde.
Jetzt sollte der Plot so aussehen:
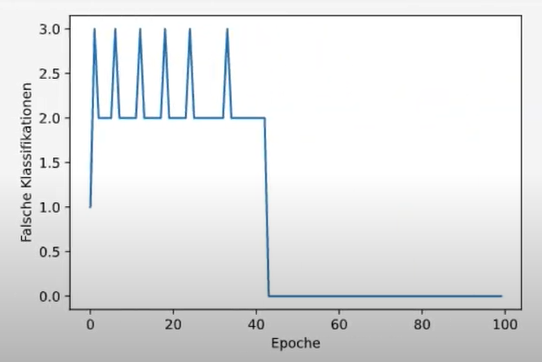
Plot Anzahl der falschen Klassifikationen:
Perzeptron anwenden
Um das Perzeptron in der Praxis anwenden zu können, müssen wir den Code noch anpassen. Sodass wir die Klassifikation mit neuen Daten machen können. Neue Eingabedaten sehen zum Beispiel so aus: x_neu = [24.5, 13.8, 1] – also unskalierte Werte plus Bias. Damit das Modell korrekt arbeitet, muss zwischen skalierten Trainingsdaten und unskalierten Anwendungsdaten unterschieden werden. Dafür gibt es die Variable self.trainiert, die nach dem Lernschritt auf True gesetzt wird.
In der Perzeptron-Funktion prüfen wir mit if self.trainiert, ob das Modell trainiert wurde. Falls ja, skalieren wir die Eingabe: x /= self.skalierungsfaktor. So teilen wir durch die gleichen Werte wie beim Training.
Kleiner Trick: Einzeilige Bedingungen lassen sich direkt schreiben, z. B. return 1 if np.dot(self.w, x) > 0 else 0 Das spart Platz und macht den Code lesbarer. Statt return kann man auch eine Variable setzen – Python ist da ziemlich flexibel.
Zur Anwendung: Neue Daten holen, z. B. x_neu, und dann einfach perceptron.perzeptron(x_neu) ausführen. Das Modell klassifiziert automatisch – in unserem Beispiel ist das Tier mit 24,5 cm Länge und 13,8 cm Breite kein Hund.
Das Perzeptron mit SKLearn
Die Scikit-learn (sklearn)-Bibliothek ist ein unverzichtbares Werkzeug im Bereich des Machine Learnings. Sie bietet eine Vielzahl an vorprogrammierten Algorithmen, die das Training von Modellen deutlich vereinfachen und beschleunigen. Die Verwendung einer solchen Bibliothek hat sowohl Vor- als auch Nachteile im Vergleich zur eigenen Programmierung.
Vergleich: Eigener Code vs. Sklearn
| Kriterium | Eigener Code | Scikit-learn |
|---|---|---|
| Vorteile | – Verständnis: Man lernt die Funktionsweise des Algorithmus von Grund auf kennen. <br> – Transparenz: Jeder Schritt ist nachvollziehbar und kann visualisiert werden. <br> – Flexibilität: Man kann jeden Aspekt des Algorithmus anpassen. | – Geschwindigkeit: Die Algorithmen sind hochgradig optimiert und laufen deutlich schneller (z. B. 16-mal schneller als eine eigene Perceptron-Implementierung). <br> – Stabilität: Bietet robuste und fehlerbereinigte Implementierungen. <br> – Einfachheit: Ermöglicht die schnelle und einfache Anwendung von Algorithmen in wenigen Zeilen Code. |
| Nachteile | – Laufzeit: Die Ausführung ist langsamer. <br> – Komplexität: Mehr Codeaufwand für dieselbe Aufgabe. | – Abstraktion: Man sieht die interne Funktionsweise des Algorithmus nicht, was das Verständnis erschwert. <br> – Geringere Flexibilität: Die Anpassung ist auf die von der Bibliothek vorgesehenen Parameter beschränkt. |
Perceptron mit Sklearn
Mit Scikit-learn ist die Implementierung eines Perceptrons denkbar einfach. Anstatt den Algorithmus von Grund auf zu programmieren, wird die Perceptron-Klasse aus sklearn.linear_model importiert. Das Training des Modells erfolgt dann über die .fit()-Methode.
Einblick in Support Vector Machines (SVM)
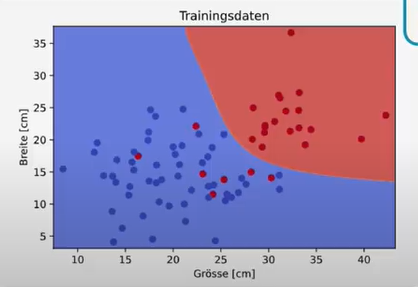
Über das Perceptron hinaus bietet Scikit-learn auch komplexere und leistungsfähigere Algorithmen, wie die Support Vector Machines (SVMs). SVMs sind eine Erweiterung des Perceptrons. Während ein Perceptron eine beliebige Trennlinie findet, optimiert eine SVM diese Linie, um den größtmöglichen Abstand zu den am nächsten liegenden Datenpunkten zu gewährleisten.
Dank sogenannter Kernels können SVMs auch mit nicht-linear trennbaren Daten umgehen und komplexere, nicht-gerade Trennlinien finden. Auch hier ist die Implementierung mit Scikit-learn einfach und effizient.
Praktische Übungen und Vertiefung
Um das erlernte Wissen nicht zu Vergessen, kann es an weiteren Machine Learning Beispielen ausprobieren.
- Algorithmus-Rekonstruktion z.B. Nachprogrammieren klassischer ML-Algorithmen (z. B. SVM) zur Vertiefung des Verständnisses
- Neuronale Netze mit PyTorch oder TensorFlow
- Modellaufbau mit Keras
Video:
#20: https://www.youtube.com/watch?v=8LosC2Fszis&list=PLIYzsTnFhywyjBon1_tE4ZGVzXAx5FpWr&index=20 #21: https://www.youtube.com/watch?v=Vjugt6Fx0kY&list=PLIYzsTnFhywyjBon1_tE4ZGVzXAx5FpWr&index=21